教學
下載資料
本頁內容10
FinLab 的資料都用 data.get('資料表:欄位') 下載,一次拿到所有股票十年以上的歷史。這一頁說明怎麼下載、怎麼找資料表名稱、怎麼只抓需要的股票,以及下載出錯時怎麼處理。
| 你想做什麼 | 用這個 | 範例 |
|---|---|---|
| 下載收盤價、成交量、財報、月營收 | data.get() | data.get('price:收盤價') |
| 查有哪些資料表與欄位 | data.search() | data.search('營收') |
| 只抓上市、上櫃或特定產業 | data.universe() | with data.universe(market='TSE_OTC'): |
| 切換到美股資料 | data.set_market() | data.set_market('us') |
第一次使用建議先看快速上手;完整的函式說明在 finlab.data API。
下載一張資料表
一行 data.get() 就下載整個市場 10 年以上的歷史紀錄(台股 2000 檔、美股數千檔):
from finlab import data

close = data.get('price:收盤價')| date | 1101 | 2330 | 2454 |
|---|---|---|---|
| 2007-04-23 | 29.6 | 68.6 | 400 |
| 2007-04-24 | 30.25 | 69.8 | 409 |
| … | … | … | … |
| 2026-10-30 | 28.35 | 2370 | 3915 |
| 2026-11-02 | 28.1 | 2330 | 3970 |
from finlab import data

data.set_market('us')
close = data.get('price:adj_close')| date | AAPL | MSFT | TSLA |
|---|---|---|---|
| 2016-01-04 | 26.34 | 54.8 | 14.89 |
| 2016-01-05 | 25.68 | 55.05 | 14.9 |
| … | … | … | … |
| 2026-10-29 | 387.94 | 609.3 | 403.3 |
| 2026-10-30 | 383.18 | 599.84 | 399.81 |
回傳的是一張表:
- 每一列是一個市場有交易的日期。
- 每一欄是一檔股票代號,所以寫選股條件時可以整張表一起比較。
它的型別是 FinlabDataFrame,也就是擴充版的 Pandas DataFrame:Pandas 的寫法都能直接用,另外多了選股常用的功能(見下方用下載的資料做運算)。還不熟 Pandas,可以先讀 Pandas 10 分鐘上手。
免費與 VIP 的資料範圍
- 免費版台股歷史資料只到 2023-12-31(最後交易日 2023-12-29)。
- VIP 可取得最新已更新的資料:日行情通常到前一交易日,其他資料依各表的更新頻率。
- 整表開放的參考資料與美股公開測試資料,另依資料目錄的標示。
cb_price、cb_published_info、cb_converted_status是 VIP 專屬。試用到期後,未訂閱就無法再下載這些資料,使用它們的程式會收到權限錯誤。
想知道某份資料要不要 VIP、免費能拿到哪一天,用 data.search(..., details=True) 查,見下一節。
找資料表名稱
不確定資料表叫什麼,有三個方法:
- 到資料目錄查可用資料與鍵名。
- 在 AI 編程助手安裝 FinLab Skill,直接問「營收相關的資料表有哪些?」,就會拿到正確的
data.get()參數與用法範例。 - 在程式裡用
data.search()搜尋(market預設是目前的市場,沒設定時是台股;也可以指定'us'、'us_fund'、'tw'或'all'),回傳資料表:欄位(table:column)格式的名稱:
from finlab import data

# 列出台股所有欄位(預設)
all_tw = data.search()

# 台股關鍵字搜尋
close_tw = data.search('收盤')

# 美股關鍵字搜尋
close_us = data.search('close', market='us')

# 全市場搜尋
price_all = data.search('price', market='all')| 參數 | 說明 |
|---|---|
keyword | 關鍵字,不分大小寫;None 時列出全部 |
market | 'tw'(預設,台股)、'us'(美股)、'all'(台股+美股);無效的值會拋出 ValueError |
details | True 時改回傳一張表,多了權限與日期欄位(見下方) |
查權限與免費截止日
加上 details=True,每個資料集會多列出幾個欄位:
from finlab import data

data.search('cb', details=True)| 欄位 | 意思 |
|---|---|
dataset | 資料鍵名 |
auth | free 或 vip |
free_until | 免費截止日(含當日) |
requires_date_range | True 表示 data.get() 必須同時指定 start、end,見每天更新所有資料表 |
不加 details=True 時,data.search() 仍回傳原本的資料鍵名。
搜尋用的目錄從哪裡來
Catalog 來源:Firestore data_categories/finlab_tw_stock(台股)、data_categories/finlab_us_stock(美股),並使用 LRU 快取。
只抓特定市場或類股
把 data.get() 放進 with data.universe(...) 區塊,下載的資料就只有選到的股票。
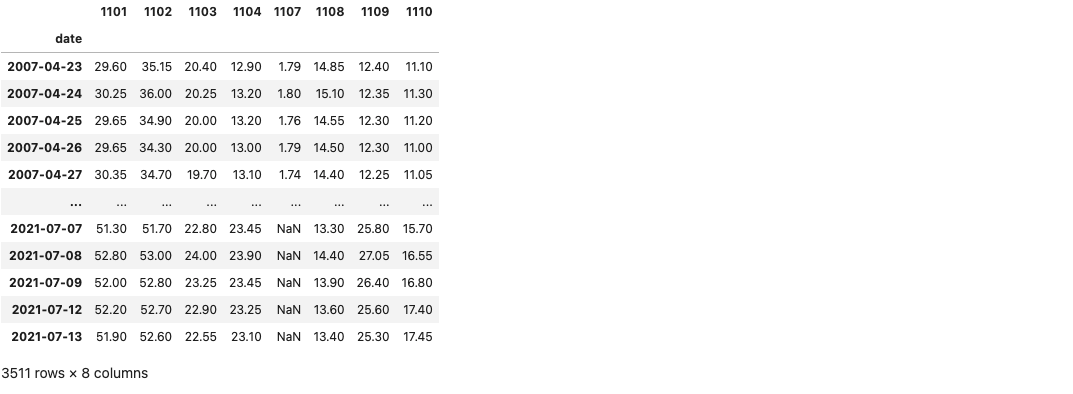
例如只取上市櫃「水泥工業」的收盤價:
from finlab import data

with data.universe(market='TSE_OTC', category=['水泥工業']):
    price = data.get('price:收盤價')
這樣就會取得上市櫃水泥產業股票的收盤價:
market(市場範圍)可選:
| 市場代碼 | 說明 |
|---|---|
ALL | 全市場,包括上市、上櫃、興櫃、公開發行等所有股票 |
TSE | 上市公司股票(在台灣證券交易所上市) |
OTC | 上櫃公司股票(在台灣證券櫃檯買賣中心上市) |
TSE_OTC | 上市櫃公司股票(包含上市及上櫃公司) |
ETF | 交易型基金,可以像股票一樣交易的基金 |
category(類股範圍)依產業分類。ETF 相關類股可用:
| 類別 | 描述 |
|---|---|
domestic_etf | 以台股為成分股之 ETF |
foreign_etf | 以國外商品為成分股之 ETF |
leveraged_etf | 槓桿型 ETF |
vanilla_futures_etf | 無槓桿期貨 ETF |
leveraged_futures_etf | 槓桿型期貨 ETF |
全部產業類股名稱
光電業
其他電子業
化學工業
半導體
塑膠工業
存託憑證
建材營造
文化創意業
橡膠工業
水泥工業
汽車工業
油電燃氣業
玻璃陶瓷
生技醫療
生技醫療業
紡織纖維
航運業
觀光事業
貿易百貨
資訊服務業
農業科技
通信網路業
造紙工業
金融
鋼鐵工業
電器電纜
電子商務
電子通路業
電子零組件
電機機械
電腦及週邊
食品工業
美股用 data.us_universe(),可依指數、產業、交易所或證券類型篩選。例如 S&P 500 裡的科技股:
from finlab import data

data.set_market('us')
with data.us_universe(index='SP500', sector='Technology'):
close = data.get('price:adj_close')| 參數 | 可用值 | 說明 |
|---|---|---|
index | 'SP500'/'SPX'、'NASDAQ100'/'NDX' | 最新的指數成分股 |
sector | 例如 'Technology' | 產業名稱,可多個,用正規表示式比對 |
industry | 例如 'Semiconductors' | 細產業名稱,可多個,用正規表示式比對 |
exchange | 'NASDAQ'、'NYSE'、'AMEX' | 掛牌交易所,可多個 |
security_type | 例如 'common_stock' | 證券類型,可多個;'common_stock' 只留美國普通股 |
美股產業(sector)有:Technology、Healthcare、Financial Services、Consumer Cyclical、Industrials、Communication Services、Consumer Defensive、Energy、Basic Materials、Real Estate、Utilities。這些值來自 data.get('us_company_profile') 的 sector、industry、exchange、security_type 欄位。
with 區塊結束後,篩選就恢復成進入區塊前的設定。
只選名稱完全相同的類股
類股名稱是用正規表示式(regex)比對,所以是模糊比對:category 寫「其他」,會選出所有名稱含「其他」的類股,包含「其他證券」。只想要「其他」、不要「其他證券」時,在前後加上 ^ 與 $:
from finlab import data

with data.universe('TSE_OTC', ['^其他$']):
    close_subset = data.get('price:收盤價')
    print(close_subset)
這樣就明確指定開頭到結尾只有「其他」,只有這個類股會被選出來。美股的 sector、industry 也一樣,例如 sector='^Energy$'。
排除特定類股
exclude_category 可在範圍內排除特定類股,接受字串或清單,同樣用正規表示式模糊比對,預設為 None。
from finlab import data

# 僅選取上市櫃的「水泥工業」相關類股,且排除「金融」相關類股
with data.universe(market='TSE_OTC', category=['水泥工業'], exclude_category=['金融']):
    price = data.get('price:收盤價')
同時設定 category 與 exclude_category 時,會先選出符合 category 的股票,再排除符合 exclude_category 的。
在伺服器或排程上登入
下載前要先登入。在 Jupyter/Colab、本機 Python 與 VSCode,都可以直接呼叫瀏覽器登入流程:
import finlab

finlab.login()
沒有瀏覽器可用的自動化環境,改用環境變數登入,就不會跳出瀏覽器驗證:
在本機登入
在自己的電腦執行上面的 finlab.login(),完成瀏覽器登入。
匯出憑證
在同一台電腦的終端機執行:
python -m finlab token --env會印出 FINLAB_REFRESH_TOKEN、FINLAB_SESSION_ID、FINLAB_API_KEY 三個值。
在自動化環境設成環境變數
打開命令提示字元,輸入:
set FINLAB_REFRESH_TOKEN=<YOUR_REFRESH_TOKEN>
set FINLAB_SESSION_ID=<YOUR_SESSION_ID>
set FINLAB_API_KEY=<YOUR_API_KEY>
打開終端機,輸入:
export FINLAB_REFRESH_TOKEN=<YOUR_REFRESH_TOKEN>
export FINLAB_SESSION_ID=<YOUR_SESSION_ID>
export FINLAB_API_KEY=<YOUR_API_KEY>
舊版 token 登入
舊版的 FINLAB_API_TOKEN 環境變數與 finlab.login('token') 仍可相容,但已不建議把 token 寫進程式碼。
用下載的資料做運算
data.get() 回傳的 FinlabDataFrame 繼承自 Pandas DataFrame,支援所有 Pandas 運算,並額外提供選股常用的 accessor(.cs、.sector、.weight)。
算報酬率、均線與條件
from finlab import data

close = data.get('price:收盤價')
rev = data.get('monthly_revenue:當月營收')

# 算術
ret = close / close.shift() - 1  # 日報酬率
rev_yoy = rev / rev.shift(12) - 1  # 月營收年增率

# 滾動計算
ma20 = close.average(20)  # 20 日均線(FinLab 擴充)
std20 = close.rolling(20).std()  # 20 日波動率

# 比較 → boolean DataFrame
cond = close > ma20  # 股價站上均線
golden_cross = ma20 > close.average(60)  # 均線黃金交叉

# 邏輯組合
position = cond & golden_cross  # 同時滿足
position = cond | golden_cross  # 滿足其一
from finlab import data
data.set_market('us')
close = data.get('price:adj_close')
rev = data.get('us_income_statement:revenue') # 季資料
# 算術
ret = close / close.shift() - 1 # 日報酬率
rev_yoy = rev / rev.shift(4) - 1 # 季營收年增率
# 滾動計算
ma20 = close.average(20) # 20 日均線(FinLab 擴充)
std20 = close.rolling(20).std() # 20 日波動率
# 比較 → boolean DataFrame
cond = close > ma20 # 股價站上均線
golden_cross = ma20 > close.average(60) # 均線黃金交叉
# 邏輯組合
position = cond & golden_cross # 同時滿足
position = cond | golden_cross # 滿足其一挑出最大或最小的幾檔
pe = data.get('price_earning_ratio:本益比')

position = pe.is_smallest(10)  # 本益比最低 10 檔
position = pe.is_largest(10)  # 本益比最高 10 檔
ranked = pe.rank(axis=1, pct=True)  # 每日百分位排名
eps = data.get('us_income_statement:eps_diluted')
raw_close = data.get('price:close') # 估值用未還原股價
pe = raw_close / eps.rolling(4).sum() # 近四季本益比
pe = pe[pe > 0] # 排除虧損公司
position = pe.is_smallest(10) # 本益比最低 10 檔
position = pe.is_largest(10) # 本益比最高 10 檔
ranked = pe.rank(axis=1, pct=True) # 每日百分位排名每天跨股票排名與標準化(.cs)
df.cs(cross-sectional)在每個日期、跨所有股票計算,適合做因子排名、標準化:
roe = data.get('fundamental_features:ROE稅後')

roe.cs.rank()  # 每日跨股票百分位排名
roe.cs.zscore()  # 每日標準化(均值 0,標準差 1)
roe.cs.winsorize(0.05, 0.95)  # 每日百分位縮尾(去極端值)
roe.cs.bucket(5)  # 每日五等分分組
roe.cs.demean()  # 每日去均值

# 實戰:選出 ROE 排名前 20% 的股票
position = roe.cs.rank() > 0.8
net_income = data.get('us_income_statement:net_income')
equity = data.get('us_balance_sheet:total_stockholders_equity')
roe = net_income / equity # 季 ROE
roe.cs.rank() # 每日跨股票百分位排名
roe.cs.zscore() # 每日標準化(均值 0,標準差 1)
roe.cs.winsorize(0.05, 0.95) # 每日百分位縮尾(去極端值)
roe.cs.bucket(5) # 每日五等分分組
roe.cs.demean() # 每日去均值
# 實戰:選出 ROE 排名前 20% 的股票
position = roe.cs.rank() > 0.8在同產業內比較(.sector)
df.sector 在同產業內計算,適合做產業中性化分析。轉換類方法和 .cs 相同,另有產業統計值:
# 轉換:與 .cs 相同的方法,但在同產業內計算
roe.sector.rank()  # 產業內排名
roe.sector.zscore()  # 產業內標準化(≈ 產業中性化)

# 聚合:取得產業統計值
roe.sector.mean()  # 產業平均 ROE
roe.sector.std()  # 產業 ROE 標準差
roe.sector.median()  # 產業中位數

# 實戰:選出在各自產業內 ROE 排名前 30% 的股票
position = roe.sector.rank() > 0.7
美股要傳入「股票代號 → 產業」的對照;不傳時,.sector 用的是台股產業分類。
profile = data.get('us_company_profile')
sectors = dict(zip(profile['symbol'], profile['sector']))

# 轉換:與 .cs 相同的方法,但在同產業內計算
roe.sector(sectors).rank()  # 產業內排名
roe.sector(sectors).zscore()  # 產業內標準化(≈ 產業中性化)

# 聚合:取得產業統計值
roe.sector(sectors).mean()  # 產業平均 ROE
roe.sector(sectors).std()  # 產業 ROE 標準差
roe.sector(sectors).median()  # 產業中位數

# 實戰:選出在各自產業內 ROE 排名前 30% 的股票
position = roe.sector(sectors).rank() > 0.7
決定每檔的權重(.weight)
df.weight 從選股結果建構更精細的權重,可以一路串接:
position = roe.cs.rank() > 0.8  # 先選股

# 鏈式建構權重
weights = (
    position.weight.inverse_volatility(window=60)  # 反波動率加權
    .weight.cap_industry(max_weight=0.3)  # 產業權重上限 30%
    .rebalance('ME')  # 只留換股日,換手率才是每次換股之間的
    .weight.limit_turnover(max_turnover=0.3)  # 換手率上限 30%
)
美股要傳 price=close:不傳時,inverse_volatility 讀的是台股還原股價。weight.cap_industry() 是依台股產業分類設上限。
position = roe.cs.rank() > 0.8  # 先選股

# 鏈式建構權重
weights = (
    position.weight.inverse_volatility(window=60, price=close)  # 反波動率加權
    .rebalance('ME')  # 只留換股日,換手率才是每次換股之間的
    .weight.limit_turnover(max_turnover=0.3)  # 換手率上限 30%
)
更多方法請見 finlab.dataframe 參考文件。
一次下載很多資料
data.gets() 平行批次下載多張表,下載更快,回傳的仍是一般的 FinlabDataFrame。用完後可以呼叫 data.free_memory() 釋放記憶體:
import os
from finlab import data

os.environ['FINLAB_MAX_DOWNLOAD_WORKERS'] = '1'
close, volume = data.gets('price:收盤價', 'price:成交股數')

del close, volume  # 不再需要時,先移除自己的參照
data.free_memory()下載執行緒數:FINLAB_MAX_DOWNLOAD_WORKERS 控制 data.get()、data.gets() 的 Python 下載執行緒數,預設為 8,必須是正整數。設成 1 時在呼叫的執行緒中依序下載,適合執行緒數受限的環境。這個設定在每次下載時讀取;Pyodide 維持原有的下載方式。
釋放記憶體:data.free_memory() 釋放資料與產業分類的記憶體快取,保留 FileStorage 的磁碟檔案、時間資訊及現有設定,下一次讀取可從磁碟載入。要注意:
CacheStorage沒有磁碟備份,釋放後需要重新下載。- 你自己仍持有的 DataFrame 不會被釋放,所以要先
del。 - Python 不保證立即把記憶體還給作業系統。
顯示或回報下載進度
data.get() 與 data.gets() 支援 progress='display' | 'event' | 'silent'。Agent/worker 建議用 event 或 silent,避免建立 Jupyter HTML display。
from finlab import data

events = []
close, volume = data.gets(
    "price:收盤價",
    "price:成交股數",
    progress="event",
    progress_callback=events.append,
)
每個事件的 schema 為 {phase, dataset?, completed?, total?, cache_hit?, download_bytes?, elapsed_ms, timestamp}。
每天更新所有資料表
要每天把資料更新到本機時,用 requires_date_range 把資料分成兩類:
False:可直接呼叫data.get(key),仍須符合登入、資料權限與配額。True:日期分區資料,data.get()必須同時指定start、end。
from finlab import data

catalog = data.search('', market='tw', details=True)  # 美股改用 market='us'
whole_tables = catalog.loc[~catalog['requires_date_range'], 'dataset']

# 一般資料集可照原有 FileStorage 設定逐項更新
for key in whole_tables:
    data.get(key)

# 日期分區另外指定商品與已發布的日期
ticks = data.get('tw_tick:2330', start='2026-06-01', end='2026-06-01')tw_tick:2330、tw_minute:2330、tw_futures_minute:TX_202610 是三個日期分區家族的範例,並非全商品名錄;請依需要替換股票或契約及日期,見盤後逐筆與分鐘資料。
這個欄位只說明是否必填日期,與資料頻率無關:intraday_trading 是日頻資料,tw_price_60min 是可整表下載的 60 分 K 寬表,兩者都標為 False。不要依名稱或頻率排除資料表。
常見錯誤
DatasetNotFoundError:找不到資料表
data.get() 找不到資料表時會丟出 finlab.exceptions.DatasetNotFoundError(RuntimeError 的子類別),錯誤訊息會列出最接近的正確名稱:
from finlab import data
from finlab.exceptions import DatasetNotFoundError

try:
    close = data.get('price:收盤')   # 欄位名稱不正確
except DatasetNotFoundError as e:
    print(e)   # 訊息會列出最接近的名稱,例如 price:收盤價
可能的原因:
- 資料表名稱拼錯(正確是「收盤價」,不是「收盤」)。
- 資料庫裡沒有這張表。
- 尚未登入或登入已失效,無法存取資料。
用 data.search('收盤') 找正確名稱,或到資料目錄查詢。名稱正確卻仍下載失敗,請檢查:是否已執行 finlab.login() 完成登入、網路連線是否正常、帳號是否有該資料的會員權限。
下載成功,但表是空的
close = data.get('price:收盤價')
print(close)
# Empty DataFrame
# Columns: []
# Index: []
可能的原因:
data.truncate_start/data.truncate_end把資料表的所有日期都排除了。- 免費帳號下載的資料不在可用範圍內。
- 資料來源暫時沒有資料。
data.universe() 的條件一檔都對不到(例如類股名稱打錯)時,不會回傳空表,而是丟出 ValueError。類股名稱請對照全部產業類股名稱,下載後再檢查資料量:
from finlab import data

try:
    with data.universe(market='TSE', category=['不存在的類股']):   # 對不到任何股票
        close = data.get('price:收盤價')
except ValueError as e:
    print(e)

with data.universe(market='TSE', category=['水泥工業']):
    close = data.get('price:收盤價')

if close.empty:
    print('資料為空:truncate_start/truncate_end 排除了所有日期,或資料表本身沒有資料')
elif close.shape[0] < 10 or close.shape[1] < 10:
    print(f'資料偏少:{close.shape[0]} 個交易日,{close.shape[1]} 檔股票')
else:
    print(f'資料正常:{close.shape[0]} 個交易日,{close.shape[1]} 檔股票')
網路逾時
下載時長時間沒有回應,最後拋出逾時或連線錯誤:
close = data.get('price:收盤價')
# finlab.exceptions.SignedDownloadReadTimeout: Download of price:收盤價 failed (connection timed out). Check your network, proxy or firewall, then retry data.get().
可能的原因:網路連線不穩定、下載的資料量過大(例如全市場 10 年以上的資料)、伺服器暫時無法回應。
逾時的錯誤是 DataError,kind 為 "timeout"。等幾秒再試一次;再失敗就檢查網路,稍後再試:
import time
from finlab import data
from finlab.exceptions import DataError

try:
    close = data.get('price:收盤價')
except DataError as e:
    if getattr(e, "kind", None) != "timeout":
        raise
    time.sleep(5)  # 等待 5 秒後重試
    close = data.get('price:收盤價')
finlab 會自動快取下載過的資料,第二次執行時會讀取快取。
登入或權限驗證失敗
無法登入、憑證過期,或下載資料時出現權限錯誤。可能的原因:
- 尚未完成瀏覽器登入,或本機憑證已過期。
- 自動化環境的
FINLAB_REFRESH_TOKEN、FINLAB_SESSION_ID、FINLAB_API_KEY設定不完整。 - 帳戶權限不足,例如免費帳號存取 VIP 專屬資料。
重新登入,再用最新日期確認拿到的是不是最新資料:
import finlab
from finlab import data

finlab.login()  # 依瀏覽器登入流程完成驗證

close = data.get('price:收盤價')
print(f'資料存取正常,最新日期:{close.index[-1]}')

if close.index[-1].year < 2024:
    print('目前使用的是免費版,僅能存取較舊的資料')
還是失敗時,請檢查:瀏覽器登入是否完成、帳戶是否為有效的 VIP 會員、自動化環境是否已設定上面三個環境變數、網路連線是否正常。要升級 VIP 取得最新資料,請到方案頁;帳戶與資料權限可在會員專區查看。更多問題見常見問題。
下一步
這一頁有幫到你嗎?