教學
因子分析
本頁內容8
一個策略通常由好幾個選股條件組成,每個條件就是一個「因子」。這一頁教你量化每個因子和策略報酬的關係,用數據而不是感覺決定要增加、刪掉或修改哪個因子。
分析流程
先把策略拆成兩張表,再交給 finlab.tools.factor_analysis 的函式:
- 特徵(features):每個月、每檔股票,各因子是否成立。
- 標籤(labels):每檔股票下個月的報酬,減掉所有股票的平均報酬(超額報酬)。
| 函式 | 輸入 | 得到 | 回答的問題 |
|---|---|---|---|
calc_factor_return() | 特徵、標籤 | 因子報酬 | 這個因子帶來多少超額報酬? |
calc_centrality() | 因子報酬 | 因子集中度 | 這個因子是不是太擁擠? |
calc_shapley_values() | 特徵、標籤 | 因子貢獻度 | 含有這個因子的組合表現好不好? |
calc_ic() | 原始因子值、標籤 | 因子相關性(IC) | 因子值能不能預測未來報酬? |
calc_regression_stats() | 上面任一項隨時間變化的結果 | 趨勢統計 | 這項指標正在變強還是變弱? |
把策略轉成特徵與標籤
寫出範例策略
這個策略由三個很基本的因子組成:市值、營收、動能。三個條件同時成立才買進,每月換股。
from finlab import data
from finlab.backtest import sim

marketcap = data.get('etl:market_value')
revenue = data.get('monthly_revenue:當月營收')
price = data.get('etl:adj_close')

cond1 = marketcap.rank(pct=True, axis=1) < 0.3
cond2 = (revenue.average(3) / revenue.average(12)).rank(pct=True, axis=1) > 0.7
cond3 = (price / price.shift(20)).rank(pct=True, axis=1) > 0.7

pos = cond1 & cond2 & cond3

report = sim(pos, resample='ME', upload=False)
report.creturn.plot()
營收因子是近 3 個月平均營收除以近 12 個月平均營收。
from finlab import data
from finlab.backtest import sim

data.set_market('us')
with data.us_universe(index='SP500'):
    marketcap = data.get('etl:us_market_value')
    revenue = data.get('us_income_statement:revenue')
    price = data.get('price:adj_close')

cond1 = marketcap.rank(pct=True, axis=1) < 0.3
cond2 = (revenue / revenue.shift(4)).rank(pct=True, axis=1) > 0.7
cond3 = (price / price.shift(20)).rank(pct=True, axis=1) > 0.7

pos = cond1 & cond2 & cond3

report = sim(pos, resample='ME', upload=False)
report.creturn.plot()
股票池是 S&P 500 成分股,營收因子是季營收的年增率。
rank(pct=True, axis=1) 是每天在所有股票之間排名,換算成 0 到 1 的百分位:cond1 取市值最小的 30%,cond2、cond3 取營收成長和 20 日漲幅最高的 30%。
製作特徵與標籤
feature.combine() 把三個條件合成一張特徵表,label.excess_over_mean() 算出每檔股票未來 1 個月的超額報酬。兩者都用 resample='ME',日期才會對得上。下面的輸出和本頁的圖表都是台股範例的結果:
from finlab import data
import finlab.ml.feature as feature
import finlab.ml.label as label

features = feature.combine(
    {'marketcap': cond1, 'revenue': cond2, 'momentum': cond3}, resample='ME'
)

# 計算未來 1M 的標籤
labels = label.excess_over_mean(index=features.index, resample='ME')

features.dropna().head()| datetime | instrument | marketcap | revenue | momentum |
|---|---|---|---|---|
| 2013-04-30 | 1101 | False | True | True |
| 2013-04-30 | 1102 | False | True | True |
| 2013-04-30 | 1103 | False | True | False |
| 2013-04-30 | 1104 | False | True | False |
| 2013-04-30 | 1108 | False | True | False |
特徵表的索引是(datetime, instrument):每個月底、每檔股票一列,每個因子一欄。
labels.dropna().head()datetime instrument
2007-04-30 1101 0.042548
1102 0.081764
1103 -0.016863
1104 -0.047492
1108 -0.002247
dtype: float64標籤是索引相同的 Series:每檔股票下個月的報酬減掉所有股票的平均報酬。
看每個因子帶來多少報酬
因子報酬(factor return)衡量一個因子在一段時間內帶來多少超額報酬,常用來評估因子是否有效、值不值得投資。把每個因子的報酬累加起來,就能看出它長期的表現和穩定度,作為挑選與組合因子的依據。
from finlab.tools.factor_analysis import calc_factor_return
from finlab.plot import plot_line

plot_line(
    calc_factor_return(features, labels).cumsum(),
    unit='.0%',
    title='Factor Cumulative Return',
)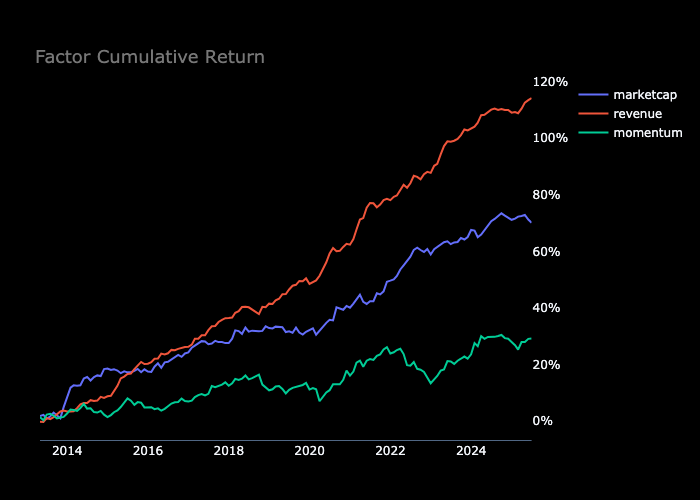
累積報酬一路上升的因子,一直在貢獻超額報酬;走平或下滑的因子,在這段期間沒有幫上忙。圖中可以看到月營收因子的效果明顯比較好,市值因子的效果較差。
看因子是不是太擁擠
因子集中度(factor centrality)量化因子報酬之間的「共同性」,也就是這個因子有多擁擠:
其中 為因子對於第一主成分的佔比,$k$ 為因子總數。
| 集中度 | 代表 | 怎麼用 |
|---|---|---|
| 越大 | 用這個因子選股,近期績效比較好;但集中度越高,未來回檔的風險也越高 | 密切觀察 |
| 越小 | 用這個因子選股,近期績效較差;未來回檔的風險較低 | 在擁擠度低的時候密切觀察,等擁擠度上升初期再用這個因子選股 |
calc_centrality() 的第二個參數是滾動視窗的長度(幾列資料),下面用 12,也就是 12 個月:
from finlab.tools.factor_analysis import calc_centrality

plot_line(calc_centrality(calc_factor_return(features, labels), 12), title='Centrality')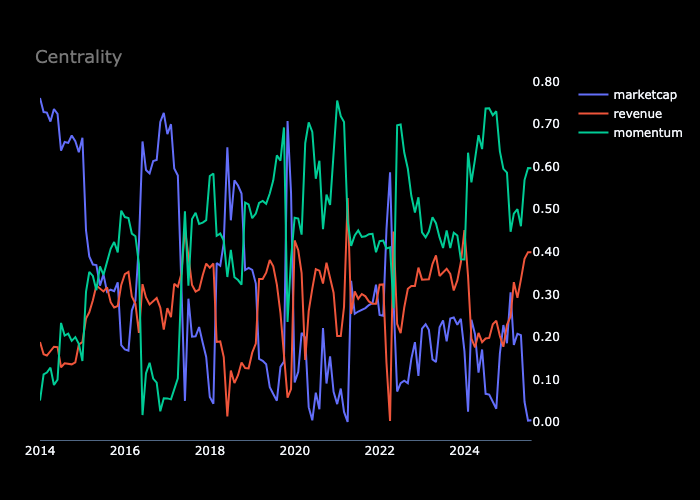
上圖中,市值因子目前擁擠度較低,可以換一個因子,讓策略更穩定;也可以密切觀察市值因子,等擁擠度上升初期再用它選股(因子回歸效應)。
看因子在組合裡的貢獻
calc_shapley_values() 枚舉所有因子組合。每個時間點,取同時符合組合內所有因子的股票,算它們的等權平均超額報酬(沒有股票時記 0),再平分給組合內的每個因子;每個因子的貢獻度,是它參與的所有組合分到的報酬總和。
from finlab.tools.factor_analysis import calc_shapley_values

plot_line(calc_shapley_values(features, labels))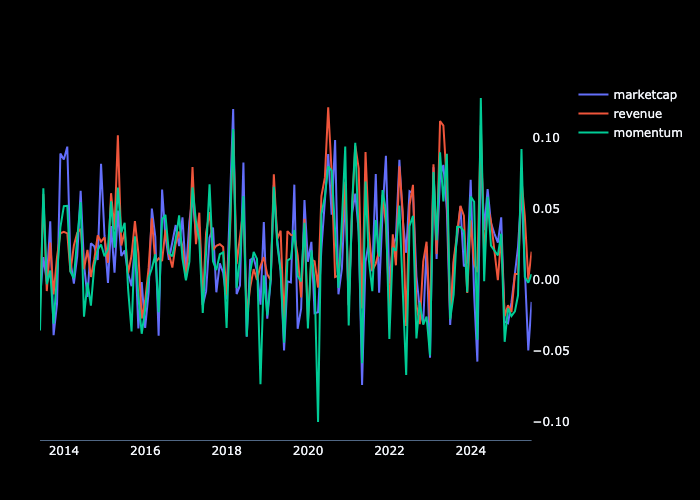
值越高,代表含有該因子的組合表現越好。
看因子能不能預測報酬
因子 IC(information coefficient)是衡量因子預測能力的重要指標,也就是因子分數和未來報酬之間的相關性:
其中 表示相關係數(通常為皮爾森相關), 為因子分數, 為未來一段期間的資產報酬。IC 通常介於 -1 到 1:
| IC | 意思 |
|---|---|
| 接近 1 | 因子對未來報酬有很強的正向預測能力 |
| 接近 -1 | 因子對未來報酬有很強的反向預測能力 |
| 接近 0 | 因子對未來報酬幾乎沒有預測能力 |
IC 是判斷因子是否有效的重要依據,IC 越高的因子通常越值得納入投資組合。
IC 要用連續的因子值,不能用 True/False,所以要另外做一張原始值的特徵表。rank=True 會在每個日期把因子值和標籤都換成排名再算相關(Spearman 排名相關,也就是 Rank IC);不設時用皮爾森相關。
from finlab.tools.factor_analysis import calc_ic

features_raw = feature.combine(
    {
        'marketcap': -marketcap,  # 小市值
        'revenue': revenue.average(3) / revenue.average(12),
        'momentum': price / price.shift(20),
    },
    resample='ME',
)

plot_line(calc_ic(features_raw, labels, rank=True))
from finlab.tools.factor_analysis import calc_ic
features_raw = feature.combine(
{
'marketcap': -marketcap, # 小市值
'revenue': revenue / revenue.shift(4),
'momentum': price / price.shift(20),
},
resample='ME',
)
plot_line(calc_ic(features_raw, labels, rank=True))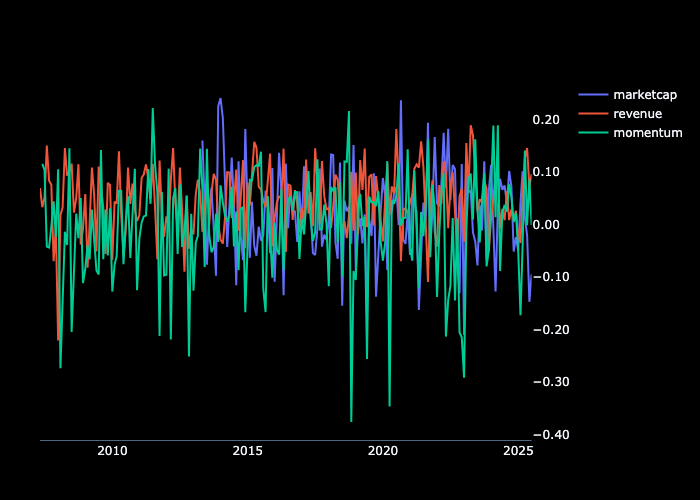
判斷因子正在變強還是變弱
集中度、貢獻度、IC 都是隨時間變化的數值。calc_regression_stats() 對每個因子的走勢做線性迴歸,告訴你它是上升、下降還是持平:
from finlab.tools.factor_analysis import calc_regression_stats

centrality_df = calc_centrality(calc_factor_return(features, labels), 12)
centrality_trend = calc_regression_stats(centrality_df)| slope | p_value | r_squared | tail_estimate | trend | |
|---|---|---|---|---|---|
| marketcap | -0.000111 | 3.102740e-17 | 0.404468 | 0.0123 | down |
| revenue | 0.000018 | 4.861743e-03 | 0.056041 | 0.0087 | flat |
| momentum | 0.000093 | 1.146515e-17 | 0.412914 | 0.0215 | up |
| 欄位 | 說明 | 數值範圍 | 含義 |
|---|---|---|---|
| slope | 線性回歸斜率 | (-∞, +∞) | 趨勢方向和強度:正值是上升(擁擠度增加),負值是下降(擁擠度減少),絕對值越大趨勢越強 |
| p_value | 統計顯著性 | [0, 1] | 趨勢的可信度 |
| r_squared | 決定係數 | [0, 1] | 線性模型的解釋力 |
| tail_estimate | 尾部估計值 | (-∞, +∞) | 時間序列末端的預測值 |
| trend | 趨勢分類 | "up"/"down"/"flat" | 簡化的趨勢判斷 |
只有 p_value < 0.05 而且 r_squared > 0.1 時,trend 才會是 up 或 down,否則是 flat。這兩個門檻是參數 p_value_threshold 與 r_squared_threshold 的預設值。
| p_value | r_squared | slope | trend | 含義 |
|---|---|---|---|---|
| 小 | 高 | 正 | up | 強烈且穩定的上升趨勢 |
| 小 | 高 | 負 | down | 強烈且穩定的下降趨勢 |
| 小 | 低 | 任意 | flat | 趨勢存在但效果小/雜訊大 |
| 大 | 高 | 任意 | flat | 樣本少,雜訊高,無法判斷 |
| 大 | 低 | 任意 | flat | 基本無趨勢且模型無解釋力 |
解讀上面的結果
| 因子 | 數值 | 解讀 |
|---|---|---|
| 市值(marketcap) | slope -0.000111(負值)、p_value 3.10e-17(極度顯著)、r_squared 0.40(中等偏強解釋力)、trend down | 集中度呈現非常強烈且統計上極度顯著的下降趨勢 |
| 營收(revenue) | slope 0.000018(正值)、p_value 0.0048(顯著)、r_squared 0.056(解釋力較弱)、trend flat | 有統計上顯著的上升趨勢,但解釋力不足(r_squared < 0.1),被歸類為 flat |
| 動能(momentum) | slope 0.000093(顯著正值)、p_value 1.14e-17(極度顯著)、r_squared 0.41(中等偏強解釋力)、trend up | 集中度呈現非常強烈且統計上極度顯著的上升趨勢。這是明確的信號:動能因子非常「熱門」,大量資金正在追逐這個策略 |
p_value 與 r_squared 的分級
p_value(統計顯著性)
- [0, 0.01]:極度顯著(***)
- [0.01, 0.05]:高度顯著(**)
- [0.05, 0.1]:邊際顯著(*)
- [0.1, 1]:不顯著
r_squared(決定係數)
- [0.8, 1.0]:極強解釋力
- [0.6, 0.8):強解釋力
- [0.4, 0.6):中等解釋力
- [0.2, 0.4):弱解釋力
- [0, 0.2):很弱解釋力
下一步
- 因子擁擠度分析範例 用集中度追蹤因子的擁擠程度。
- 機器學習 用同樣的特徵與標籤訓練選股模型。
- 策略參數優化 一次回測所有條件組合,挑出最好的一組。
- finlab.tools 因子分析函式的完整參數。
這一頁有幫到你嗎?